本章目录 本章讨论一些较为进阶的主题——马尔可夫链、随机游走、鞅与动态规划——这些内容通常不会出现在概率论的入门课程中。与基础概率论不同,这些工具或许不能算作量化面试的“标准必备知识”;但掌握随机过程与动态规划,能够简化很多面试题的解法,并在面试中形成一定优势。学会这些基础以后,你还会发现,许多面试题会从“需要灵机一动的谜题”变成“可以按方法系统求解的问题”。
5.1 马尔可夫链(Markov Chain)
马尔可夫链是一列随机变量
X 0 , X 1 , … , X n , … X_0,X_1,\ldots,X_n,\ldots 马尔可夫性质 :给定当前状态后,未来状态与过去状态无关。也就是说,对任意
n n
P ( X n + 1 = j ∣ X n = i , X n − 1 = i n − 1 , … , X 0 = i 0 ) = p i j = P ( X n + 1 = j ∣ X n = i ) .
P(X_{n+1}=j\mid X_n=i,X_{n-1}=i_{n-1},\ldots,X_0=i_0)
=p_{ij}
=P(X_{n+1}=j\mid X_n=i).
其中,i i j j S = { s 1 , s 2 , … , s M } S=\{s_1,s_2,\ldots,s_M\}
对于齐次马尔可夫链 (homogeneous Markov
chain),从状态
i i j j n n M M M × M M\times M
P = ( p i j ) = ( p 11 p 12 ⋯ p 1 M p 21 p 22 ⋯ p 2 M ⋮ ⋮ ⋱ ⋮ p M 1 p M 2 ⋯ p M M ) ,
P=(p_{ij})=
\begin{pmatrix}
p_{11}&p_{12}&\cdots&p_{1M}\\
p_{21}&p_{22}&\cdots&p_{2M}\\
\vdots&\vdots&\ddots&\vdots\\
p_{M1}&p_{M2}&\cdots&p_{MM}
\end{pmatrix},
其中
p i j p_{ij} i i j j
初始概率为
P ( X 0 = i ) , i = 1 , … , M , ∑ i P ( X 0 = i ) = 1 .
P(X_0=i),\qquad i=1,\ldots,M,\qquad \sum_i P(X_0=i)=1.
一条路径
X 1 = i 1 , X 2 = i 2 , … , X n = i n X_1=i_1,X_2=i_2,\ldots,X_n=i_n X 0 = i 0 X_0=i_0
P ( X 1 = i 1 , … , X n = i n ∣ X 0 = i 0 ) = p i 0 i 1 p i 1 i 2 ⋯ p i n − 1 i n .
P(X_1=i_1,\ldots,X_n=i_n\mid X_0=i_0)
=p_{i_0i_1}p_{i_1i_2}\cdots p_{i_{n-1}i_n}.
转移图(transition
graph) 常用来图形化表示转移矩阵:节点表示状态,边表示可能的转移,边上的数值表示相应的转移概率。
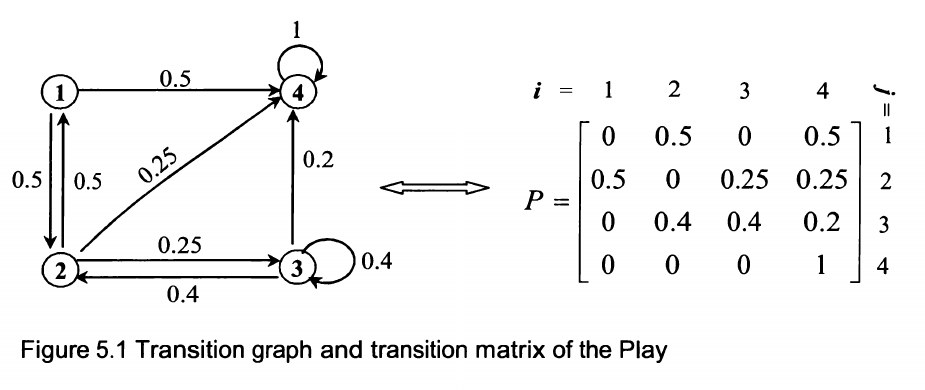
图5.1:一个四状态马尔可夫链的转移图与转移矩阵。
状态的分类(Classification
of states)
若从状态
i i j j j j 可由状态
i i (accessible from
i i n n p i j ( n ) > 0 p_{ij}^{(n)}>0 j j i i
T i j = min { n : X n = j ∣ X 0 = i } ,
T_{ij}=\min\{n:X_n=j\mid X_0=i\},
则当且仅当
P ( T i j < ∞ ) > 0 P(T_{ij}<\infty)>0 j j i i
若
j j i i i i j j i , j i,j 互通 (communicate)。例如在图5.1中,状态1、2、3互通;状态4可由状态1到达,但状态1不能由状态4到达,因此状态1与4并不互通。
如果从状态
i i i i i i 常返态 (recurrent state):
P ( T i i < ∞ ) = 1 .
P(T_{ii}<\infty)=1.
若
P ( T i i < ∞ ) < 1 ,
P(T_{ii}<\infty)<1,
则称
i i 暂态 (transient
state)。图5.1中的状态4是常返态;状态1、2、3都是暂态,因为从它们可以进入状态4,而从状态4无法回到1、2、3。
吸收马尔可夫链(Absorbing
Markov chain)
如果一旦进入状态
i i p i i = 1 p_{ii}=1 p i j = 0 ( j ≠ i ) p_{ij}=0\ (j\ne i) i i 吸收态 。若链中至少有一个吸收态,并且从任意状态出发都存在通往某个吸收态的路径,则称该马尔可夫链为吸收马尔可夫链。
在图5.1中,状态4是吸收态,因此该链是吸收马尔可夫链。
到达吸收态
A A 设
a i a_i i i A A i = A i=A a i = 1 a_i=1 a i = 0 a_i=0
a i = ∑ j p i j a j .
a_i=\sum_j p_{ij}a_j.
这个方程可以理解为:先看下一步到达哪个状态,再对其后的吸收概率做全概率分解。
期望吸收时间方程。 设
μ i \mu_i i i μ i = 0 \mu_i=0
μ i = 1 + ∑ j p i j μ j .
\mu_i=1+\sum_j p_{ij}\mu_j.
这里额外的1表示走到下一状态所需的一步。
题目:赌徒破产问题(Gambler’s
ruin problem)
玩家
M M N N M M 2 / 3 2/3 M M
我的回答与笔记 查看解答⌄
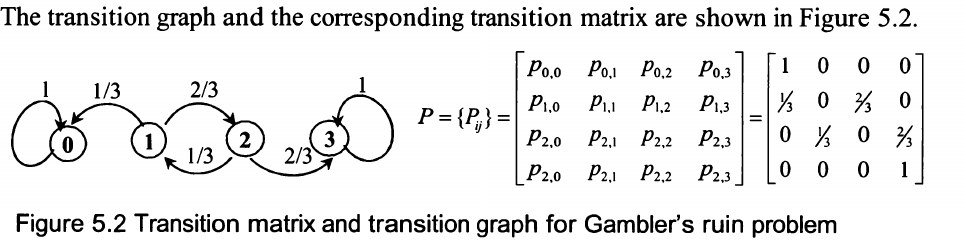
马尔可夫链问题的关键通常在于选取合适的状态空间。一个自然的状态是记录
M M
S = { 0 , 1 , 2 , 3 } ,
S=\{0,1,2,3\},
其中状态
m m M M m m M M M M
图5.2:赌徒破产问题的转移图与转移矩阵。
初始状态为
X 0 = 1 X_0=1 1 / 3 1/3 2 / 3 2/3 1 / 3 1/3 2 / 3 2/3
令
a i a_i i i
a 0 = 0 , a 3 = 1 .
a_0=0,\qquad a_3=1.
对中间状态应用吸收概率方程:
a 1 = 1 3 a 0 + 2 3 a 2 , a 2 = 1 3 a 1 + 2 3 a 3 .
\begin{aligned}
a_1&=\frac13a_0+\frac23a_2,\\
a_2&=\frac13a_1+\frac23a_3.
\end{aligned}
解得
a 1 = 4 7 , a 2 = 6 7 .
a_1=\frac47,\qquad a_2=\frac67.
因此,从1美元起步时,玩家
M M
4 7 .
\boxed{\frac47}.
题目:骰子问题(Dice question)
两名玩家押注掷两枚标准六面骰子的点数和。玩家
A A B B A A
我的回答与笔记 查看解答⌄
这道题可以直接用条件概率处理,但用马尔可夫链会更系统。
先给出条件概率方法。设
P ( A ) P(A) A A F F F = 12 F=12 F = 7 F=7 F ∉ { 7 , 12 } F\notin\{7,12\}
P ( A ) = P ( A ∣ F = 12 ) P ( F = 12 ) + P ( A ∣ F = 7 ) P ( F = 7 ) + P ( A ∣ F ∉ { 7 , 12 } ) P ( F ∉ { 7 , 12 } ) .
P(A)=P(A\mid F=12)P(F=12)+P(A\mid F=7)P(F=7)+P(A\mid F\notin\{7,12\})P(F\notin\{7,12\}).
其中
P ( F = 12 ) = 1 36 , P ( F = 7 ) = 6 36 , P ( F ∉ { 7 , 12 } ) = 29 36 .
P(F=12)=\frac1{36},\quad P(F=7)=\frac6{36},\quad P(F\notin\{7,12\})=\frac{29}{36}.
显然
P ( A ∣ F = 12 ) = 1 ,
P(A\mid F=12)=1,
而若第一次既不是7也不是12,局面与开局完全相同,所以
P ( A ∣ F ∉ { 7 , 12 } ) = P ( A ) .
P(A\mid F\notin\{7,12\})=P(A).
若第一次为7,则再看第二次。第二次为12时
A A B B
P ( A ∣ F = 7 ) = 1 36 + 29 36 P ( A ) .
P(A\mid F=7)=\frac1{36}+\frac{29}{36}P(A).
代回原式:
P ( A ) = 1 36 + 6 36 ( 1 36 + 29 36 P ( A ) ) + 29 36 P ( A ) .
P(A)=\frac1{36}+\frac6{36}\left(\frac1{36}+\frac{29}{36}P(A)\right)+\frac{29}{36}P(A).
解得
P ( A ) = 7 13 .
\boxed{P(A)=\frac7{13}}.
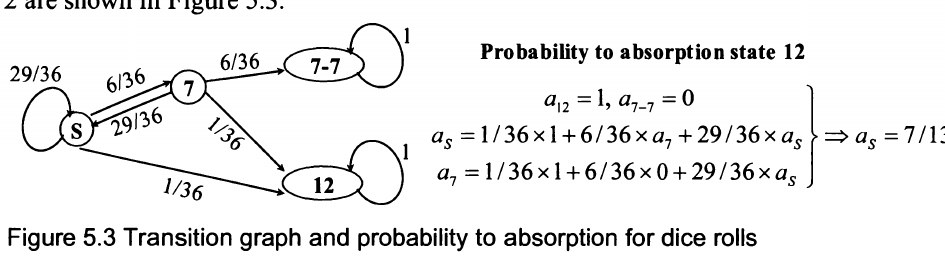
再看马尔可夫链方法。设置四个状态:
S S 7 7 7 − 7 7\!-
\!7 B B 12 12 A A
后两个是吸收态。
图5.3:骰子问题的转移图及到达吸收态12的概率方程。
令
a S a_S a 12 = 1 a_{12}=1 a 7 − 7 = 0 a_{7-7}=0
a S = 1 36 + 6 36 a 7 + 29 36 a S , a 7 = 1 36 + 29 36 a S .
\begin{aligned}
a_S&=\frac1{36}+\frac6{36}a_7+\frac{29}{36}a_S,\\
a_7&=\frac1{36}+\frac{29}{36}a_S.
\end{aligned}
解得
a S = 7 / 13 a_S=7/13 A A 7 / 13 7/13
题目:硬币三连序列
A(Coin triplets, Part A)
连续抛一枚公平硬币。得到连续三个正面
H H H HHH T H H THH
我的回答与笔记 查看解答⌄
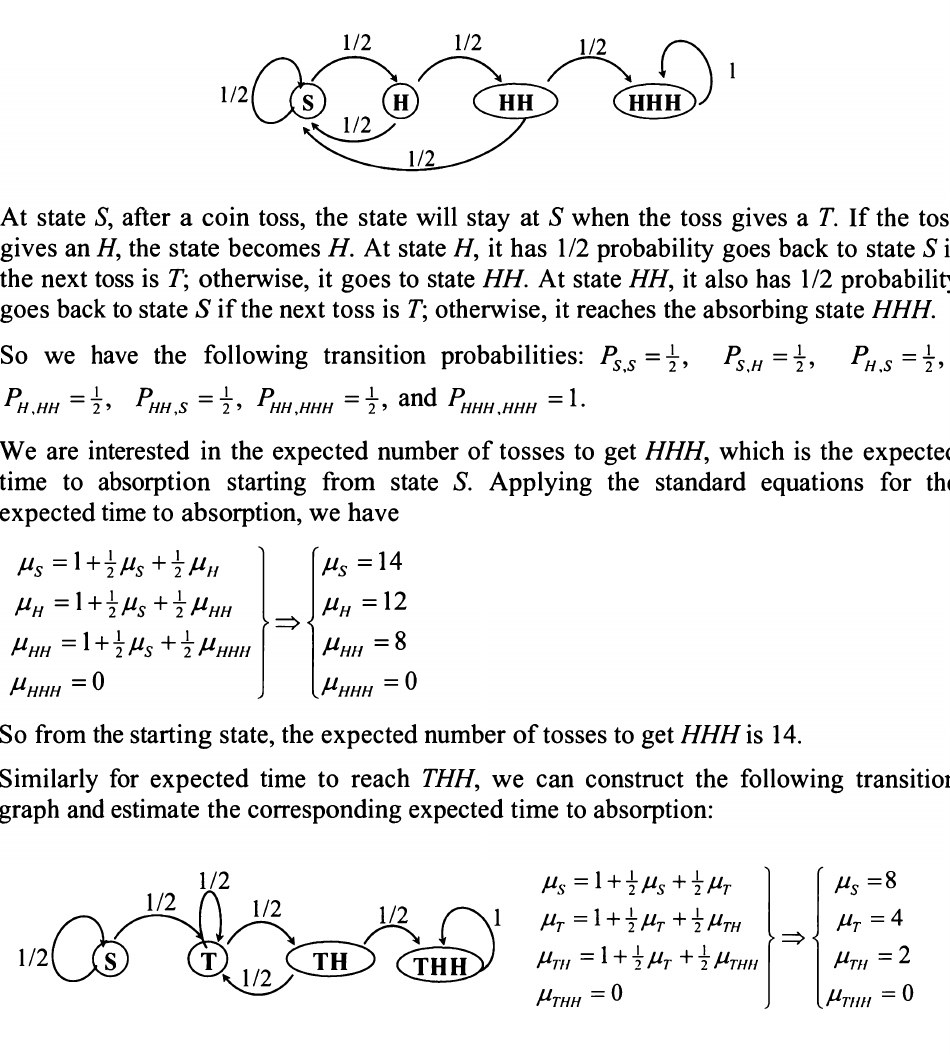
对于
H H H HHH
S S T T H H H H H H HH H H H H H HHH
达到序列 HHH 的状态转移图。
设
μ S , μ H , μ H H , μ H H H \mu_S,\mu_H,\mu_{HH},\mu_{HHH}
μ S = 1 + 1 2 μ S + 1 2 μ H , μ H = 1 + 1 2 μ S + 1 2 μ H H , μ H H = 1 + 1 2 μ S + 1 2 μ H H H , μ H H H = 0 .
\begin{aligned}
\mu_S&=1+\frac12\mu_S+\frac12\mu_H,\\
\mu_H&=1+\frac12\mu_S+\frac12\mu_{HH},\\
\mu_{HH}&=1+\frac12\mu_S+\frac12\mu_{HHH},\\
\mu_{HHH}&=0.
\end{aligned}
解得
μ S = 14 , μ H = 12 , μ H H = 8 .
\mu_S=14,\qquad \mu_H=12,\qquad \mu_{HH}=8.
因此得到
H H H HHH
14 .
\boxed{14}.
对于
T H H THH S , T , T H , T H H S,T,TH,THH T T T T T T T T
μ S = 1 + 1 2 μ S + 1 2 μ T , μ T = 1 + 1 2 μ T + 1 2 μ T H , μ T H = 1 + 1 2 μ S + 1 2 μ T H H , μ T H H = 0 .
\begin{aligned}
\mu_S&=1+\frac12\mu_S+\frac12\mu_T,\\
\mu_T&=1+\frac12\mu_T+\frac12\mu_{TH},\\
\mu_{TH}&=1+\frac12\mu_S+\frac12\mu_{THH},\\
\mu_{THH}&=0.
\end{aligned}
解得
μ S = 8 , μ T = 4 , μ T H = 2 .
\mu_S=8,\qquad \mu_T=4,\qquad \mu_{TH}=2.
所以得到
T H H THH
8 .
\boxed{8}.
题目:硬币三连序列
B(Coin triplets, Part B)
持续抛一枚公平硬币,直到
H H H HHH T H H THH H H H HHH
我的回答与笔记 查看解答⌄
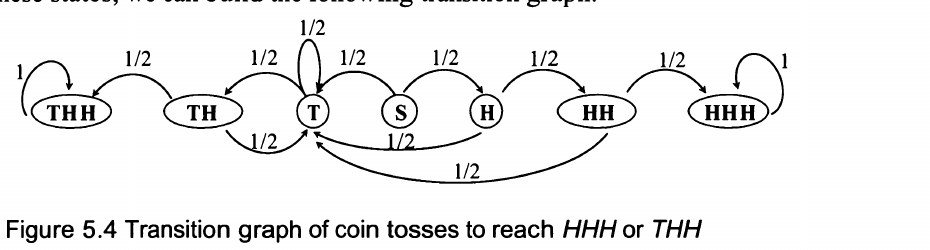
可以建立马尔可夫链。只需记录与两个目标序列有关的“最长有效后缀”,可用状态
S , H , H H , T , T H , H H H , T H H .
S,\ H,\ HH,\ T,\ TH,\ HHH,\ THH.
其中
H H H HHH T H H THH
图5.4:抛硬币直到 HHH 或 THH 出现的状态转移图。
令
a i a_i i i H H H HHH
a H H H = 1 , a T H H = 0 .
a_{HHH}=1,\qquad a_{THH}=0.
由转移关系得到
a S = 1 2 a T + 1 2 a H , a T = 1 2 a T + 1 2 a T H , a H = 1 2 a T + 1 2 a H H , a T H = 1 2 a T + 1 2 a T H H , a H H = 1 2 a T + 1 2 a H H H .
\begin{aligned}
a_S&=\frac12a_T+\frac12a_H,\\
a_T&=\frac12a_T+\frac12a_{TH},\\
a_H&=\frac12a_T+\frac12a_{HH},\\
a_{TH}&=\frac12a_T+\frac12a_{THH},\\
a_{HH}&=\frac12a_T+\frac12a_{HHH}.
\end{aligned}
解得
a S = 1 8 .
\boxed{a_S=\frac18}.
因此
H H H HHH 1 / 8 1/8 T H H THH 7 / 8 7/8
这道题其实还有一个更简洁的观察:如果最终先出现的是
H H H HHH T T T T H H T H H THH H H H HHH H H H HHH H H ( 1 / 2 ) 3 = 1 / 8 (1/2)^3=1/8
题目:硬币三连序列
C(Coin triplets, Part C)
现在把游戏改成:玩家1先选择一个长度为3的硬币序列,玩家2看到后选择另一个不同的长度为3的序列。随后连续抛公平硬币,谁的序列先出现谁获胜。若两人都完全理性并希望最大化自己的胜率,你愿意先选还是后选?若后选,最大胜率是多少?
我的回答与笔记 查看解答⌄
一个常见误区是认为,总存在某个“最强”的三连序列可以压过其他序列。这种想法往往来自错误的传递性假设:如果序列
A A B B B B C C A A C C
事实上,不论玩家1先选什么,玩家2总能选择一个胜率超过
1 / 2 1/2
下面给出完整胜率表。行表示玩家2选择的序列,列表示玩家1选择的序列,表格中的数值为玩家2的胜率。
HHH —
1/8
2/5
1/2
3/10
5/12
2/5
1/2
THH 7/8 —
1/2
3/4 1/3
1/2
1/2
3/5
HTH 3/5
1/2
—
1/3
3/8
1/2
1/2
7/12
HHT 1/2
1/4
2/3 —
1/2
5/8
2/3 7/10
TTH 7/10
2/3 5/8
1/2
—
2/3 1/4
1/2
THT 7/12
1/2
1/2
3/8
1/3
—
1/2
3/5
HTT 3/5
1/2
1/2
1/3
3/4 1/2
—
7/8
TTT 1/2
2/5
5/12
3/10
1/2
2/5
1/8
—
对玩家1来说,为了把玩家2能取得的最大胜率压到最低,最合理的选择是
H T H HTH H T T HTT T H H THH T H T THT
2 3
\boxed{\frac23}
的胜率。因此,理性玩家应选择后手 。
原书同时指出,这一题较难;相关现象可参见 V. C. Hombas 的论文
Waiting Time and Expected Waiting Time—Paradoxical
Situations (The American Statistician , Vol. 51, No. 2, May
1997, pp. 130–133)。本书这里只讨论直观思路。
题目:彩球同色(Color balls)
盒中有
n n
我的回答与笔记 查看解答⌄
令
N n N_n n n F i F_i i i
E [ N n ] = ∑ i = 1 n E [ N n ∣ F i ] P ( F i ) .
E[N_n]=\sum_{i=1}^{n}E[N_n\mid F_i]P(F_i).
由于颜色完全对称,P ( F i ) = 1 / n P(F_i)=1/n E [ N n ∣ F 1 ] E[N_n\mid F_1]
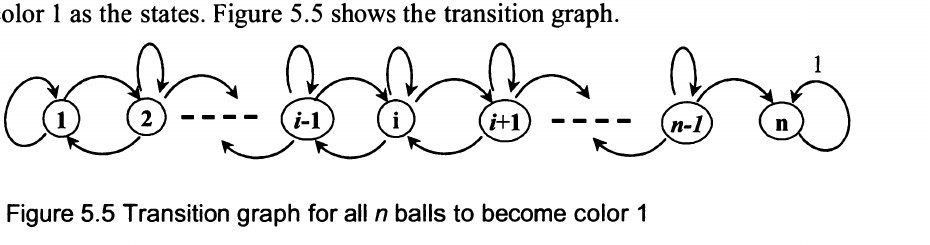
给定最终颜色是1,可以只记录当前有多少个球已经是颜色1。设状态
i i i i i = 1 , 2 , … , n i=1,2,\ldots,n n n
图5.5:给定最终颜色为1时,颜色1球数的状态转移图。
令
Z i = E [ N n ∣ X = i , F 1 ] Z_i=E[N_n\mid X=i,F_1] F 1 F_1 i i i ± 1 i\pm1
由对称性,当前有
i i
P ( F 1 ∣ X = i ) = i n .
P(F_1\mid X=i)=\frac{i}{n}.
若不条件于
F 1 F_1 i i i − 1 i-1 i i n − i n-i
P ( X t + 1 = i − 1 ∣ X t = i ) = i ( n − i ) n ( n − 1 ) .
P(X_{t+1}=i-1\mid X_t=i)=\frac{i(n-i)}{n(n-1)}.
同理,
P ( X t + 1 = i + 1 ∣ X t = i ) = ( n − i ) i n ( n − 1 ) .
P(X_{t+1}=i+1\mid X_t=i)=\frac{(n-i)i}{n(n-1)}.
再应用贝叶斯公式,在给定最终到达颜色1的条件下可得
P i , i − 1 ∣ F 1 = ( i − 1 ) ( n − i ) i ( n − 1 ) , P i , i + 1 ∣ F 1 = ( n − i ) ( i + 1 ) i ( n − 1 ) .
P_{i,i-1\mid F_1}=\frac{(i-1)(n-i)}{i(n-1)},
\qquad
P_{i,i+1\mid F_1}=\frac{(n-i)(i+1)}{i(n-1)}.
其余概率对应停留在状态
i i
Z i = 1 + Z i − 1 P i , i − 1 ∣ F 1 + Z i P i , i ∣ F 1 + Z i + 1 P i , i + 1 ∣ F 1 ,
Z_i
=1+Z_{i-1}P_{i,i-1\mid F_1}+Z_iP_{i,i\mid F_1}+Z_{i+1}P_{i,i+1\mid F_1},
整理为
( n − i ) 2 i Z i = n ( n − 1 ) + ( n − i ) ( i + 1 ) Z i + 1 + ( n − i ) ( i − 1 ) Z i − 1 .
(n-i)\,2i\,Z_i
=n(n-1)+(n-i)(i+1)Z_{i+1}+(n-i)(i-1)Z_{i-1}.
配合边界条件
Z n = 0 Z_n=0
Z i = ( n − i ) 2 .
\boxed{Z_i=(n-i)^2}.
初始时每种颜色只有一个球,即
i = 1 i=1
E [ N n ] = ( n − 1 ) 2 .
\boxed{E[N_n]=(n-1)^2}.
5.2 鞅与随机游走(Martingale
and Random Walk)
随机游走(Random walk)
设
{ X i : i ≥ 1 } \{X_i:i\ge 1\}
S n = X 1 + ⋯ + X n ,
S_n=X_1+\cdots+X_n,
则过程
{ S n : n ≥ 1 } \{S_n:n\ge1\} 随机游走 。这个名称来自把
S n S_n n n X 1 , X 2 , … X_1,X_2,\ldots
若
X i X_i + 1 +1 − 1 -1 p p 1 − p 1-p S n S_n p p 简单随机游走 。进一步地,若
p = 1 / 2 p=1/2 对称随机游走 。对称随机游走中,
E [ S n ] = 0 , var ( S n ) = E [ S n 2 ] − E [ S n ] 2 = E [ S n 2 ] = n .
E[S_n]=0,
\qquad
\operatorname{var}(S_n)=E[S_n^2]-E[S_n]^2=E[S_n^2]=n.
对称随机游走是数量面试中经常出现的随机过程之一。题目常围绕:第一次达到某个阈值
a a a a
鞅(Martingale)
随机过程
{ Z n : n ≥ 1 } \{Z_n:n\ge1\}
E [ | Z n | ] < ∞ ,
E[|Z_n|]<\infty,
且对所有
n n
E [ Z n + 1 ∣ Z n = z n , Z n − 1 = z n − 1 , … , Z 1 = z 1 ] = z n ,
E[Z_{n+1}\mid Z_n=z_n,Z_{n-1}=z_{n-1},\ldots,Z_1=z_1]=z_n,
则称其为鞅 。更一般地,如果过程还依赖其他随机变量,可以把条件信息扩展为整个过去的信息集合;其含义仍是:在已知全部当前信息时,下一期的条件期望等于当前值,因此这个过程在条件期望意义下“没有趋势”。
对称随机游走本身就是鞅:
E [ S n + 1 ∣ S n ] = S n .
E[S_{n+1}\mid S_n]=S_n.
此外,
S n 2 − n
S_n^2-n
也是鞅。因为
E [ S n + 1 2 ∣ S n ] = E [ ( S n + X n + 1 ) 2 ∣ S n ] = S n 2 + 1 ,
E[S_{n+1}^2\mid S_n]
=E[(S_n+X_{n+1})^2\mid S_n]
=S_n^2+1,
故
E [ S n + 1 2 − ( n + 1 ) ∣ S n ] = S n 2 − n .
E[S_{n+1}^2-(n+1)\mid S_n]=S_n^2-n.
停时(Stopping time)
对一列 IID 随机变量
X 1 , X 2 , … X_1,X_2,\ldots N N { N = n } \{N=n\} X 1 , … , X n X_1,\ldots,X_n X n + 1 , X n + 2 , … X_{n+1},X_{n+2},\ldots N N 停时 。直观上,决定是否在时刻
n n
Wald 等式(Wald’s Equality)
令
N N E [ N ] < ∞ E[N]<\infty
S N = X 1 + X 2 + ⋯ + X N .
S_N=X_1+X_2+\cdots+X_N.
则在适当条件下,Wald 等式给出
E [ S N ] = E [ X ] E [ N ] .
\boxed{E[S_N]=E[X]E[N]}.
一个简洁的证明如下。令
I n I_n { N ≥ n } \{N\ge n\}
S N = ∑ n = 1 ∞ X n I n .
S_N=\sum_{n=1}^{\infty}X_nI_n.
由于
I n I_n X 1 , … , X n − 1 X_1,\ldots,X_{n-1} I n I_n X n X_n
E [ X n I n ] = E [ X n ] E [ I n ] = E [ X ] P ( N ≥ n ) .
E[X_nI_n]=E[X_n]E[I_n]=E[X]P(N\ge n).
于是
E [ S N ] = ∑ n = 1 ∞ E [ X n I n ] = E [ X ] ∑ n = 1 ∞ P ( N ≥ n ) = E [ X ] E [ N ] .
E[S_N]
=\sum_{n=1}^{\infty}E[X_nI_n]
=E[X]\sum_{n=1}^{\infty}P(N\ge n)
=E[X]E[N].
另一个常用结论是:鞅在合适的停时处停止后,仍然保持鞅性质 。本章后面的题目会多次利用这一点。
题目:醉汉走桥(Drunk man)
一个醉汉站在一座100米长的桥上,当前位置距离左端17米。每一步他都有50%的概率向前或向后移动1米。问:他先走到100米处而不是0米处的概率是多少?到达任一端点所需步数的期望是多少?
我的回答与笔记 查看解答⌄
这类问题在马尔可夫链里可以看作带两个吸收边界的随机游走。用鞅方法更简洁。
把当前位置平移,使初始点为0。则左端变为
− 17 -17 83 83
S n = X 1 + ⋯ + X n ,
S_n=X_1+\cdots+X_n,
其中
X i = ± 1 X_i=\pm1 1 / 2 1/2 N N − 17 -17 83 83 S n S_n S n 2 − n S_n^2-n
设
p = P ( S N = 83 ) ,
p=P(S_N=83),
则
P ( S N = − 17 ) = 1 − p .
P(S_N=-17)=1-p.
由
E [ S N ] = E [ S 0 ] = 0 E[S_N]=E[S_0]=0
83 p − 17 ( 1 − p ) = 0 ,
83p-17(1-p)=0,
所以
p = 0.17 .
\boxed{p=0.17}.
再由
S n 2 − n S_n^2-n
E [ S N 2 − N ] = E [ S 0 2 ] = 0 .
E[S_N^2-N]=E[S_0^2]=0.
因此
E [ N ] = E [ S N 2 ] = 83 2 × 0.17 + 17 2 × 0.83 .
E[N]=E[S_N^2]
=83^2\times0.17+17^2\times0.83.
原书在此处给出的数值是
1441 .
\boxed{1441}.
需要注意:按上面的等式直接计算,结果为
83 × 17 = 1411 83\times17=1411 E [ N ] = α β E[N]=\alpha\beta
更一般地,如果对称随机游走从0出发,在上边界
α > 0 \alpha>0 − β -\beta β > 0 \beta>0
P ( 先到 α ) = β α + β , E [ N ] = α β .
P(\text{先到 }\alpha)=\frac{\beta}{\alpha+\beta},
\qquad
E[N]=\alpha\beta.
题目:骰子游戏(Dice game)
反复掷一枚公平六面骰。每次掷出的点数就是当次获得的金额;若掷出4、5或6,可以继续掷;一旦掷出1、2或3,游戏立即结束。问这场游戏的期望收益是多少?
我的回答与笔记 查看解答⌄
第四章曾用全期望公式求过这道题。这里用 Wald 等式。
每一次掷骰的点数期望为
E [ X ] = 1 + 2 + 3 + 4 + 5 + 6 6 = 7 2 .
E[X]=\frac{1+2+3+4+5+6}{6}=\frac72.
每次继续游戏的概率为
1 / 2 1/2 1 / 2 1/2 N N
E [ N ] = 1 1 / 2 = 2 .
E[N]=\frac{1}{1/2}=2.
于是由 Wald 等式,
E [ S N ] = E [ X ] E [ N ] = 7 2 × 2 = 7 .
E[S_N]=E[X]E[N]=\frac72\times2=\boxed{7}.
题目:售票队伍(Ticket line)
售票处前排着
2 n 2n n n n n 2 n 2n
我的回答与笔记 查看解答⌄
把持5美元的人记为
+ 1 +1 − 1 -1
总共有
( 2 n n )
\binom{2n}{n}
条由
n n + 1 +1 n n − 1 -1
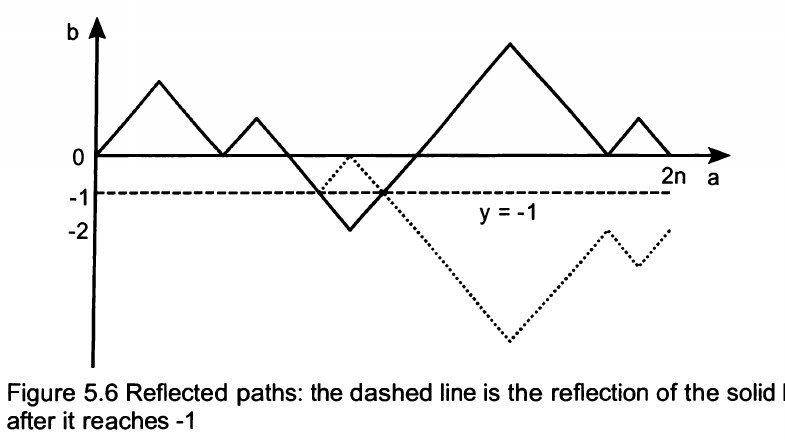
要计算“坏路径”的数量,即至少一次到达
− 1 -1 反射原理(reflection
principle) :对一条第一次到达
− 1 -1 − 1 -1 y = − 1 y=-1 − 1 -1 + 1 +1
( 2 n n − 1 ) .
\binom{2n}{n-1}.
图5.6:反射原理。虚线为实线路径在第一次到达 −1 后的反射。
所以好路径数量为
( 2 n n ) − ( 2 n n − 1 ) .
\binom{2n}{n}-\binom{2n}{n-1}.
所求概率为
( 2 n n ) − ( 2 n n − 1 ) ( 2 n n ) = 1 n + 1 .
\frac{\binom{2n}{n}-\binom{2n}{n-1}}{\binom{2n}{n}}
=\boxed{\frac1{n+1}}.
题目:连续正面序列(Coin
sequence)
有一枚公平硬币。为了首次得到连续
n n
我的回答与笔记 查看解答⌄
设
E [ f ( n ) ] E[f(n)] n n
E [ f ( 1 ) ] = 2 , E [ f ( 2 ) ] = 6 , E [ f ( 3 ) ] = 14 .
E[f(1)]=2,
\qquad
E[f(2)]=6,
\qquad
E[f(3)]=14.
自然猜测
E [ f ( n ) ] = 2 n + 1 − 2 .
E[f(n)]=2^{n+1}-2.
下面用归纳思路证明。假设
E [ f ( n ) ] = 2 n + 1 − 2 .
E[f(n)]=2^{n+1}-2.
为了达到连续
n + 1 n+1 E [ f ( n ) ] E[f(n)] n n
以
1 / 2 1/2
以
1 / 2 1/2 E [ f ( n + 1 ) ] E[f(n+1)]
因此
E [ f ( n + 1 ) ] = E [ f ( n ) ] + 1 2 ⋅ 1 + 1 2 ( 1 + E [ f ( n + 1 ) ] ) .
E[f(n+1)]
=E[f(n)]+\frac12\cdot1+\frac12\bigl(1+E[f(n+1)]\bigr).
整理得
E [ f ( n + 1 ) ] = 2 E [ f ( n ) ] + 2 .
E[f(n+1)]=2E[f(n)]+2.
代入归纳假设,
E [ f ( n + 1 ) ] = 2 ( 2 n + 1 − 2 ) + 2 = 2 n + 2 − 2 .
E[f(n+1)]=2(2^{n+1}-2)+2=2^{n+2}-2.
于是
E [ f ( n ) ] = 2 n + 1 − 2 .
\boxed{E[f(n)]=2^{n+1}-2}.
原书还给出一个更一般的鞅方法,可以用于任意硬币序列的期望等待时间。
设赌局按如下方式进行:每个时刻都会有一名新赌徒带着1美元入场,并将全部资金依次押在某个给定目标序列的下一位上。每次押中,资金翻倍;押错则归零并退出。所有赌徒相互独立。
以目标序列
H H ⋯ H HH\cdots H n n H H i i x i x_i
E [ x i − x i − 1 ] = 0 ,
E[x_i-x_{i-1}]=0,
因此
x i − i x_i-i I I n n
2 n , 2 n − 1 , … , 2
2^n,2^{n-1},\ldots,2
的收益,所以总资金是
2 + 2 2 + ⋯ + 2 n = 2 n + 1 − 2 .
2+2^2+\cdots+2^n=2^{n+1}-2.
由停止后的鞅性质,
E [ x I − I ] = 0 ,
E[x_I-I]=0,
故
E [ I ] = 2 n + 1 − 2 .
E[I]=2^{n+1}-2.
这个方法还可处理任意指定的硬币序列。原书举例:目标序列为
H H T T H H HHTTHH i i 2 6 2^6 i − 4 i-4 H T HT i − 3 i-3 i − 2 i-2 T T i − 1 i-1 H H HH 2 2 2^2 i i H H 2 1 2^1
E [ x i − i ] = 2 6 + 2 2 + 2 1 − E [ i ] = 0 ,
E[x_i-i]=2^6+2^2+2^1-E[i]=0,
从而
E [ i ] = 70 .
\boxed{E[i]=70}.
这里的核心思想是:某个目标模式首次出现时,仍然存活的赌徒正好对应于该模式与自身前缀之间的重叠结构;把这些存活赌徒的终值相加,就得到等待时间期望。
5.3 动态规划(Dynamic
Programming)
动态规划(Dynamic Programming,
DP)是一组用于求解序贯决策问题 或多阶段决策问题 的通用方法。它应用非常广泛,例如金融、供应链管理和航空排班等领域。虽然理论框架并不复杂,但真正掌握动态规划通常需要较强的数学基础与严密的逻辑,因此在研究生课程中往往被认为是较难的一类内容。
面试中遇到的动态规划问题通常比较基础,而且很多时候题目并不会明确告诉你“这是动态规划”。本节重点介绍动态规划的基本逻辑,并用几道面试题展示这种方法的核心思想与威力。
一个离散时间的动态规划模型通常包含两个基本组成部分。
1. 底层离散时间动态系统
动态规划问题总可以划分为若干阶段(stages),并在每个阶段做出决策。每个阶段都有与之对应的状态。当前阶段的决策会把系统从当前状态转移到下一阶段的某个状态;在某些状态下,如果只有一个选择,那么决策本身可能是平凡的。
假设问题共有
N + 1 N+1
0 , 1 , … , N − 1 , N .
0,1,\ldots,N-1,N.
在阶段
k k 0 ≤ k ≤ N − 1 0\le k\le N-1
x k + 1 = f ( x k , u k , w k ) ,
x_{k+1}=f(x_k,u_k,w_k),
其中:
x k x_k k k u k u_k k k w k w_k
基本思想是:下一阶段的状态
x k + 1 x_{k+1} x k x_k u k u_k w k w_k x k x_k u k u_k w k w_k x k x_k u k u_k
2.
随时间可加的成本(或收益)函数
除最后一个阶段
N N
g k ( x k , u k , w k ) ,
g_k(x_k,u_k,w_k),
终端阶段的成本为
g N ( x N ) g_N(x_N)
g N ( x N ) + ∑ k = 0 N − 1 g k ( x k , u k , w k ) .
g_N(x_N)+\sum_{k=0}^{N-1}g_k(x_k,u_k,w_k).
动态优化的目标,是选择一组策略(policy)
π * = { μ 0 * , … , μ N − 1 * }
\pi^*=\{\mu_0^*,\ldots,\mu_{N-1}^*\}
来最小化期望成本,或者等价地最大化期望收益:
J π * ( x 0 ) = min π E [ g N ( x N ) + ∑ k = 0 N − 1 g k ( x k , u k , w k ) ] .
J_{\pi^*}(x_0)
=\min_{\pi}E\left[g_N(x_N)+\sum_{k=0}^{N-1}g_k(x_k,u_k,w_k)\right].
动态规划算法(Dynamic
programming algorithm)
动态规划的核心是最优性原理(Principle of
Optimality) :如果从当前状态出发的一整套策略是最优的,那么从任意后续状态出发,它剩余部分的策略也必须对那个子问题最优。
因此,求解有限期动态规划问题时,通常从终点向前递推。
首先定义终端价值函数
J N ( x N ) = g N ( x N ) .
J_N(x_N)=g_N(x_N).
随后对
k = N − 1 , N − 2 , … , 0 k=N-1,N-2,\ldots,0
J k ( x k ) = min u k E [ g k ( x k , u k , w k ) + J k + 1 ( f ( x k , u k , w k ) ) ] .
J_k(x_k)
=\min_{u_k}
E\left[g_k(x_k,u_k,w_k)+J_{k+1}(f(x_k,u_k,w_k))\right].
最终的
J 0 ( x 0 ) J_0(x_0)
虽然这个公式看起来复杂,但实际做题时最关键的往往是两点:
找到合适的状态变量 ;
从终止状态往回倒推 。
原书指出,本节只触及动态规划的表面。若希望系统学习现代动态规划,可参考
Dimitri P. Bertsekas 的 Dynamic Programming and Optimal
Control 。
题目:动态骰子游戏(Dice game)
你最多可以掷一枚公平六面骰3次。第一次或第二次掷完后,你可以选择:
立即停止,并获得当前这次掷出的点数对应的美元金额;
放弃当前点数,继续掷骰。
如果掷到第三次,则必须接受第三次的点数并结束游戏。问:最优策略是什么?游戏开始时的期望收益是多少?
我的回答与笔记 查看解答⌄
这是一个最简单的动态规划问题。关键是从最后一个阶段往前推。
第三次掷骰时已经没有选择,因此第三次的期望收益为
E [ X 3 ] = 1 + 2 + 3 + 4 + 5 + 6 6 = 3.5 .
E[X_3]=\frac{1+2+3+4+5+6}{6}=3.5.
于是,在第二次掷骰后:
若点数为4、5、6,立即停止更好;
若点数为1、2、3,继续掷第三次更好。
因此从第二次掷骰前看,最优期望收益为
3 6 × 3.5 + 1 6 ( 4 + 5 + 6 ) = 17 4 = 4.25 .
\frac36\times3.5+\frac16(4+5+6)
=\frac{17}{4}=4.25.
再往前看第一次掷骰。第一次出现5或6时应立即停止;出现1、2、3、4时继续,因为继续的期望价值
4.25 4.25
4 6 × 4.25 + 1 6 ( 5 + 6 ) = 14 3 .
\frac46\times4.25+\frac16(5+6)
=\boxed{\frac{14}{3}}.
所以最优策略为:
第一次:5或6就停,否则继续;
第二次:4、5、6就停,否则继续;
第三次:必须接受。
题目:世界大赛下注(World
series)
波士顿红袜队与科罗拉多洛矶队进行世界大赛决赛。系列赛最多7场,先赢4场者夺冠。你目前有100美元,并计划把资金押在红袜队上。遗憾的是,你只能逐场下注,不能直接下注整个系列赛。
假设每场比赛红袜与洛矶获胜的概率都是50%。问:怎样下注,才能保证如果红袜最终夺冠,你最终拥有200美元;如果红袜最终输掉系列赛,你最终拥有0美元?
我的回答与笔记 查看解答⌄
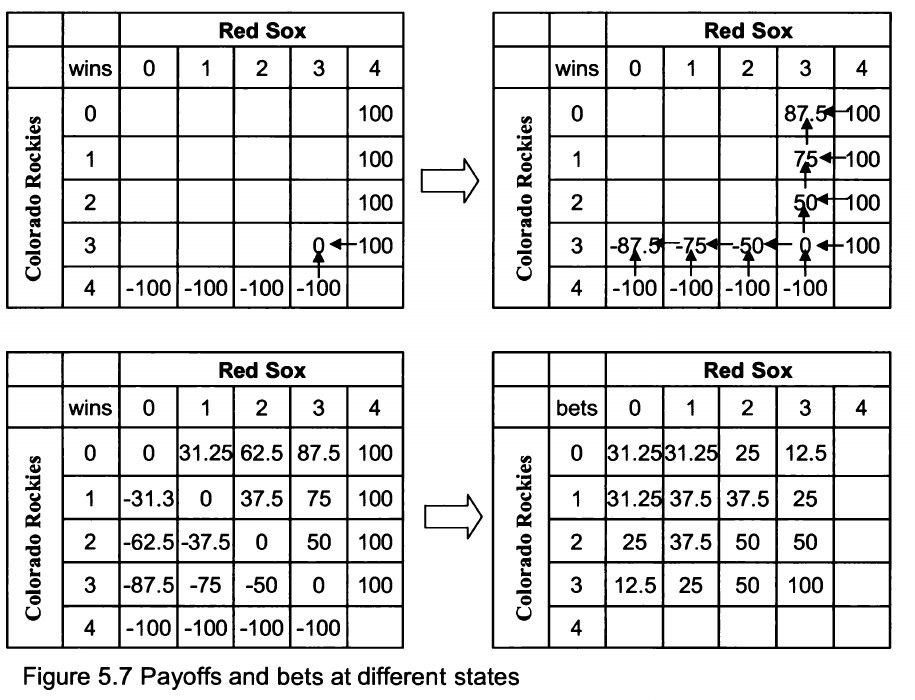
令状态
( i , j ) (i,j) i i j j
f ( i , j )
f(i,j)
为处在该状态时,为完成目标所需要的净财富价值。
终止边界很清楚:
若红袜先达到4胜,即状态
( 4 , j ) (4,j) + 100 +100
若洛矶先达到4胜,即状态
( i , 4 ) (i,4) − 100 -100
也就是说,系列赛结束时,起始100美元加上净收益
f f
现在考虑某个非终止状态
( i , j ) (i,j) y y
f ( i + 1 , j ) = f ( i , j ) + y ,
f(i+1,j)=f(i,j)+y,
而如果红袜输球,
f ( i , j + 1 ) = f ( i , j ) − y .
f(i,j+1)=f(i,j)-y.
两式相加与相减得到
f ( i , j ) = f ( i + 1 , j ) + f ( i , j + 1 ) 2 , y = f ( i + 1 , j ) − f ( i , j + 1 ) 2 .
\boxed{
\begin{aligned}
f(i,j)&=\frac{f(i+1,j)+f(i,j+1)}{2},\\
y&=\frac{f(i+1,j)-f(i,j+1)}{2}.
\end{aligned}}
这正体现了动态规划的“从终点往回算”。例如
f ( 3 , 3 ) = f ( 4 , 3 ) + f ( 3 , 4 ) 2 = 100 − 100 2 = 0 .
f(3,3)=\frac{f(4,3)+f(3,4)}{2}
=\frac{100-100}{2}=0.
逐步倒推即可得到所有状态下的价值
f ( i , j ) f(i,j)
y = f ( i + 1 , j ) − f ( i , j + 1 ) 2
y=\frac{f(i+1,j)-f(i,j+1)}{2}
得到每个状态下一场应该下注的金额。
图5.7:各系列赛状态对应的价值与下注金额。
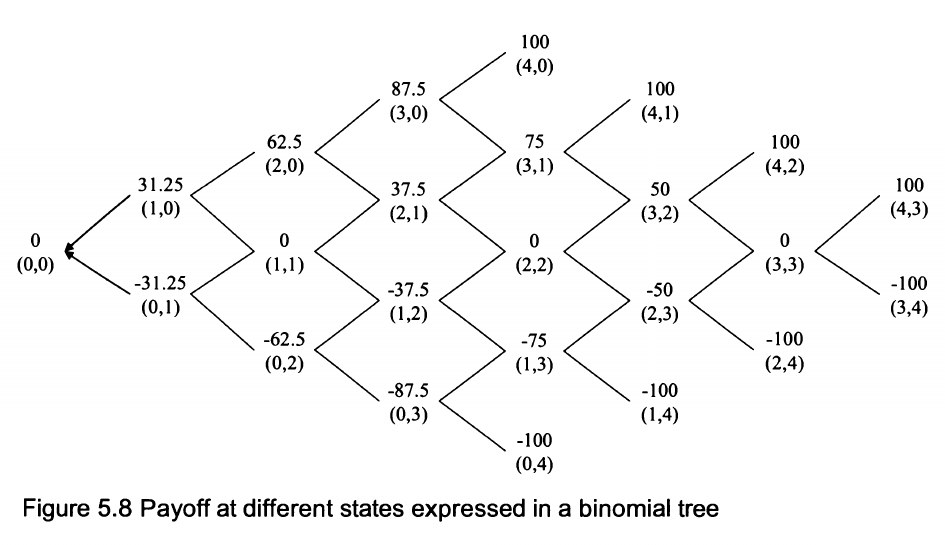
如果更习惯树状表示,也可以把同一递推过程画成二叉树:每走一步,红袜胜场数或洛矶胜场数增加1。
图5.8:世界大赛状态价值的二叉树表示。
原书进一步指出:如果把边界值看成衍生品到期收益,把每一步的胜负看作标的资产的上/下变动,那么这一结构与二叉树定价非常接近;每一步的下注额对应动态对冲中的
delta。欧洲期权与美式期权都可以用类似的动态规划方法进行数值求解。
题目:无限次数骰子游戏(Dynamic
dice game)
赌场设计了一个骰子游戏。你可以不限次数地掷一枚公平六面骰。每次掷骰后:
掷出1:赢1美元;
掷出2:赢2美元;
掷出5:赢5美元;
掷出6:此前累积的所有奖金全部损失,游戏结束;
掷出3或4:既不增加也不减少奖金。
在每次掷骰之后,如果点数是1–5,你都可以选择停止并领取当前累积奖金,或者继续掷。假设你风险中性,最多愿意支付多少钱来玩这场游戏?
我的回答与笔记 查看解答⌄
设当前已累积
n n E [ f ( n ) ] E[f(n)]
n + 1 , n + 2 , n + 3 , n + 4 , n + 5 , 0 ,
n+1,n+2,n+3,n+4,n+5,0,
每种概率都是
1 / 6 1/6
1 6 ( n + 1 ) + 1 6 ( n + 2 ) + 1 6 ( n + 3 ) + 1 6 ( n + 4 ) + 1 6 ( n + 5 ) + 1 6 ⋅ 0 = 5 6 n + 2.5 .
\frac16(n+1)+\frac16(n+2)+\frac16(n+3)+\frac16(n+4)+\frac16(n+5)+\frac16\cdot0
=\frac56n+2.5.
当
5 6 n + 2.5 > n
\frac56n+2.5>n
时,直觉上继续值得;这等价于
n < 15 n<15
对于低于停止阈值的状态,最优价值满足
E [ f ( n ) ] = 1 6 ∑ i = 1 6 E [ f ( n + i ) ] ,
E[f(n)]
=\frac16\sum_{i=1}^{6}E[f(n+i)],
其中在越过停止区域后,E [ f ( m ) ] E[f(m)] m m
E [ f ( n ) ] E[f(n)] 19.00
18.00
17.00
16.00
15.00
14.17
13.36
12.59
11.85
11.16
E [ f ( n ) ] E[f(n)] 10.52
9.91
9.34
8.80
8.29
7.81
7.36
6.93
6.53
6.15
因此在一开始
n = 0 n=0
E [ f ( 0 ) ] ≈ 6.15 .
\boxed{E[f(0)]\approx 6.15}.
所以风险中性玩家最多愿意支付约6.15美元参加游戏。
题目:动态扑克牌游戏(Dynamic
card game)
使用一副标准52张扑克牌,其中26张红牌、26张黑牌。牌充分洗匀后,庄家逐张翻牌,翻出的牌不放回。你可以在任意时刻要求庄家停止。
每翻出一张红牌,你获得1美元;每翻出一张黑牌,你损失1美元。问:最优停止策略是什么?这场游戏最多值多少钱?
我的回答与笔记 查看解答⌄
这是一个标准的动态规划最优停止问题。
设
( b , r ) (b,r) b b r r
( 26 − r ) − ( 26 − b ) = b − r .
(26-r)-(26-b)=b-r.
因此,如果此刻立即停止,收益是
b − r .
b-r.
如果继续翻下一张牌:
以
b / ( b + r ) b/(b+r) ( b − 1 , r ) (b-1,r)
以
r / ( b + r ) r/(b+r) ( b , r − 1 ) (b,r-1)
设
E [ f ( b , r ) ] E[f(b,r)] ( b , r ) (b,r)
E [ f ( b , r ) ] = max { b − r , b b + r E [ f ( b − 1 , r ) ] + r b + r E [ f ( b , r − 1 ) ] } .
\boxed{
E[f(b,r)]
=
\max\left\{
b-r,
\frac{b}{b+r}E[f(b-1,r)]
+
\frac{r}{b+r}E[f(b,r-1)]
\right\}.
}
边界条件为
f ( 0 , r ) = r , f ( b , 0 ) = b ,
f(0,r)=r,
\qquad
f(b,0)=b,
并且当
b − r b-r
从边界开始递推所有
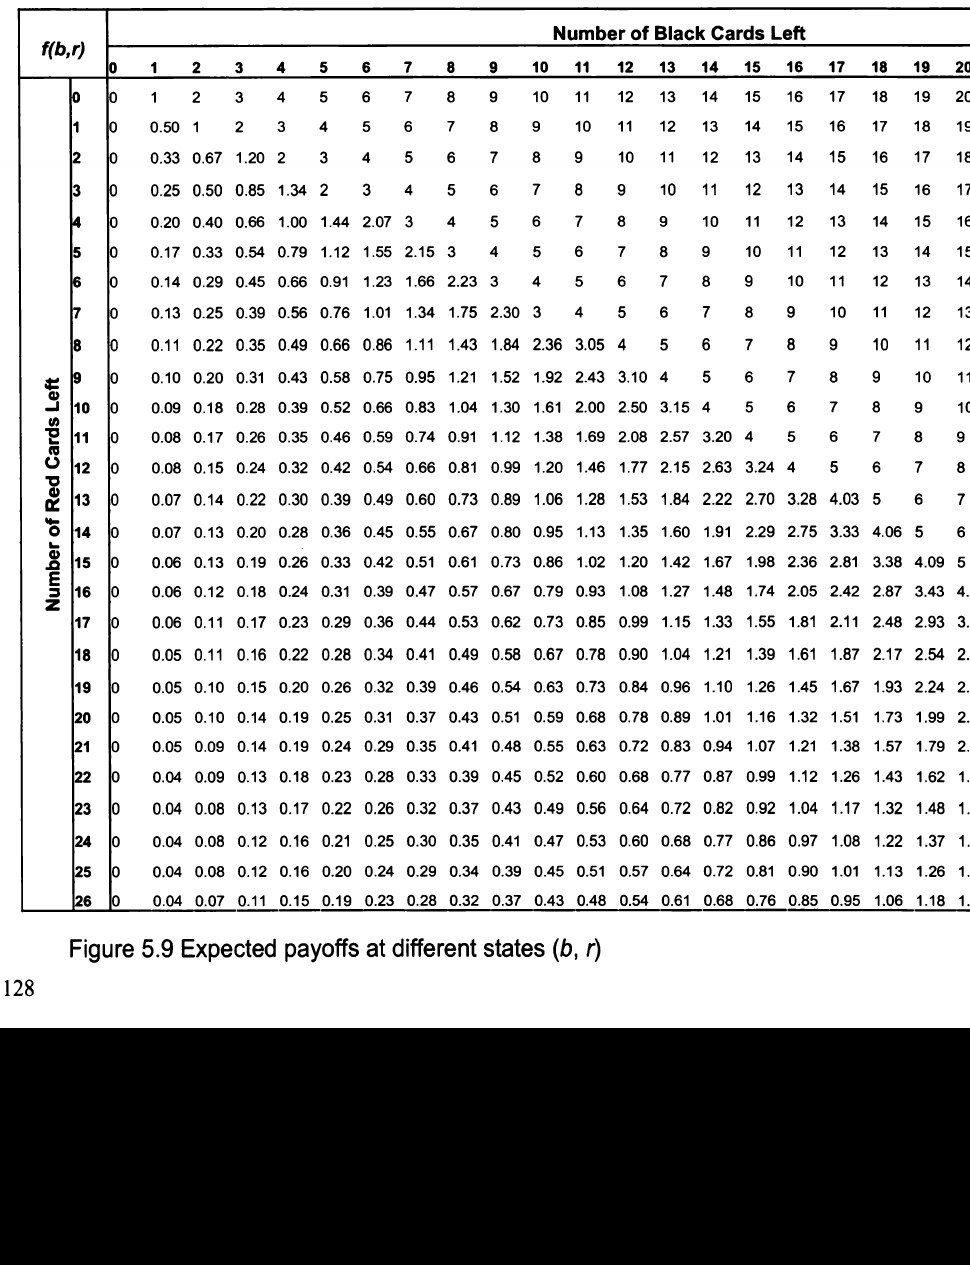
( b , r ) (b,r)
图5.9:不同剩余黑牌数
b b r r
初始状态为
( 26 , 26 ) (26,26)
E [ f ( 26 , 26 ) ] ≈ 2.62 .
\boxed{E[f(26,26)]\approx 2.62}.
因此这场游戏在最优停止策略下的价值约为2.62美元。
原书指出,这个递推结构与美式期权定价中的“立即执行价值
vs. 继续持有价值”非常相似;本质上每一步都在比较这两种选择。
5.4 布朗运动与随机微积分(Brownian
Motion and Stochastic Calculus)
本节简要讨论随机微积分中的一些问题。它可以看作连续空间随机过程的对应理论。由于布朗运动和随机微积分的基本定义、性质与定理本身就经常直接以面试题的形式出现,原书并没有先单独列出一套完整定义,而是把这些知识穿插到问题与解答中。
布朗运动(Brownian motion)
题目:布朗运动的定义与性质(Brownian
motion A)
定义布朗运动,并列举它的一些性质。
我的回答与笔记 查看解答⌄
这是最基础的布朗运动问题之一。原书特别提醒:像
W ( 0 ) = 0 W(0)=0
一个连续随机过程
W ( t ) , t ≥ 0 W(t),\ t\ge0 布朗运动 (Brownian motion,也称
Wiener process):
初始条件
W ( 0 ) = 0 .
W(0)=0.
独立增量:对于
0 ≤ t 1 ≤ t 2 ≤ ⋯ ≤ t n ,
0\le t_1\le t_2\le\cdots\le t_n,
随机变量
W ( t 1 ) − W ( 0 ) , W ( t 2 ) − W ( t 1 ) , … , W ( t n ) − W ( t n − 1 )
W(t_1)-W(0),\quad W(t_2)-W(t_1),\quad\ldots,\quad W(t_n)-W(t_{n-1})
相互独立。
正态增量:
W ( t i + 1 ) − W ( t i ) ∼ N ( 0 , t i + 1 − t i ) .
W(t_{i+1})-W(t_i)\sim N(0,t_{i+1}-t_i).
由此可得到常用性质:
路径连续,没有跳跃;
E [ W ( t ) ] = 0 E[W(t)]=0 E [ W ( t ) 2 ] = t E[W(t)^2]=t W ( t ) ∼ N ( 0 , t ) W(t)\sim N(0,t) 鞅性质:
E [ W ( t + s ) ∣ W ( t ) ] = W ( t ) ;
E[W(t+s)\mid W(t)]=W(t);
cov ( W ( s ) , W ( t ) ) = s ;
\operatorname{cov}(W(s),W(t))=s;
与布朗运动密切相关的两个重要鞅为:
Y ( t ) = W ( t ) 2 − t ,
Y(t)=W(t)^2-t,
以及指数鞅
Z ( t ) = exp { λ W ( t ) − 1 2 λ 2 t } ,
Z(t)=\exp\left\{\lambda W(t)-\frac12\lambda^2t\right\},
其中
λ \lambda
原书在后文利用 Itô
引理证明第一个鞅。指数鞅可用正态分布的矩母函数直接验证。利用独立增量,
W ( t + s ) = W ( t ) + [ W ( t + s ) − W ( t ) ] ,
W(t+s)=W(t)+[W(t+s)-W(t)],
其中增量服从
N ( 0 , s ) N(0,s) W ( t ) W(t)
E [ Z ( t + s ) ∣ ℱ t ] = exp { λ W ( t ) − 1 2 λ 2 t } exp { − 1 2 λ 2 s } E [ e λ ( W ( t + s ) − W ( t ) ) ] = Z ( t ) exp { − 1 2 λ 2 s } exp { 1 2 λ 2 s } = Z ( t ) .
\begin{aligned}
E[Z(t+s)\mid\mathcal F_t]
&=\exp\left\{\lambda W(t)-\frac12\lambda^2t\right\}
\exp\left\{-\frac12\lambda^2s\right\}
E\left[e^{\lambda (W(t+s)-W(t))}\right]\\
&=Z(t)\exp\left\{-\frac12\lambda^2s\right\}
\exp\left\{\frac12\lambda^2s\right\}\\
&=Z(t).
\end{aligned}
因此指数过程确实是鞅。
原书在本节中交替使用
B t B_t W ( t ) W(t)
题目:布朗运动与其平方的相关系数(Brownian
motion B)
布朗运动
B t B_t B t 2 B_t^2
我的回答与笔记 查看解答⌄
在固定时刻
t t
B t ∼ N ( 0 , t ) .
B_t\sim N(0,t).
由于正态分布关于0对称,
E [ B t ] = 0 , E [ B t 3 ] = 0 .
E[B_t]=0,
\qquad
E[B_t^3]=0.
因此
Cov ( B t , B t 2 ) = E [ B t 3 ] − E [ B t ] E [ B t 2 ] = 0 .
\operatorname{Cov}(B_t,B_t^2)
=E[B_t^3]-E[B_t]E[B_t^2]
=0.
所以其相关系数也为
0 .
\boxed{0}.
题目:P ( B 1 > 0 , B 2 < 0 ) P(B_1>0,B_2<0)
设
B t B_t
P ( B 1 > 0 , B 2 < 0 ) .
P(B_1>0,\ B_2<0).
我的回答与笔记 查看解答⌄
标准方法利用
B 1 ∼ N ( 0 , 1 ) , B 2 − B 1 ∼ N ( 0 , 1 ) ,
B_1\sim N(0,1),
\qquad
B_2-B_1\sim N(0,1),
且
B 1 B_1 B 2 − B 1 B_2-B_1
如果
B 1 = x > 0 B_1=x>0 B 2 < 0 B_2<0
B 2 − B 1 < − x .
B_2-B_1<-x.
直接积分可以写成
P ( B 1 > 0 , B 2 < 0 ) = ∫ 0 ∞ 1 2 π e − x 2 / 2 ∫ − ∞ − x 1 2 π e − y 2 / 2 d y d x .
P(B_1>0,B_2<0)
=
\int_0^\infty\frac{1}{\sqrt{2\pi}}e^{-x^2/2}
\int_{-\infty}^{-x}\frac{1}{\sqrt{2\pi}}e^{-y^2/2}\,dy\,dx.
利用极坐标积分,原书得到
P ( B 1 > 0 , B 2 < 0 ) = 1 8 .
\boxed{P(B_1>0,B_2<0)=\frac18}.
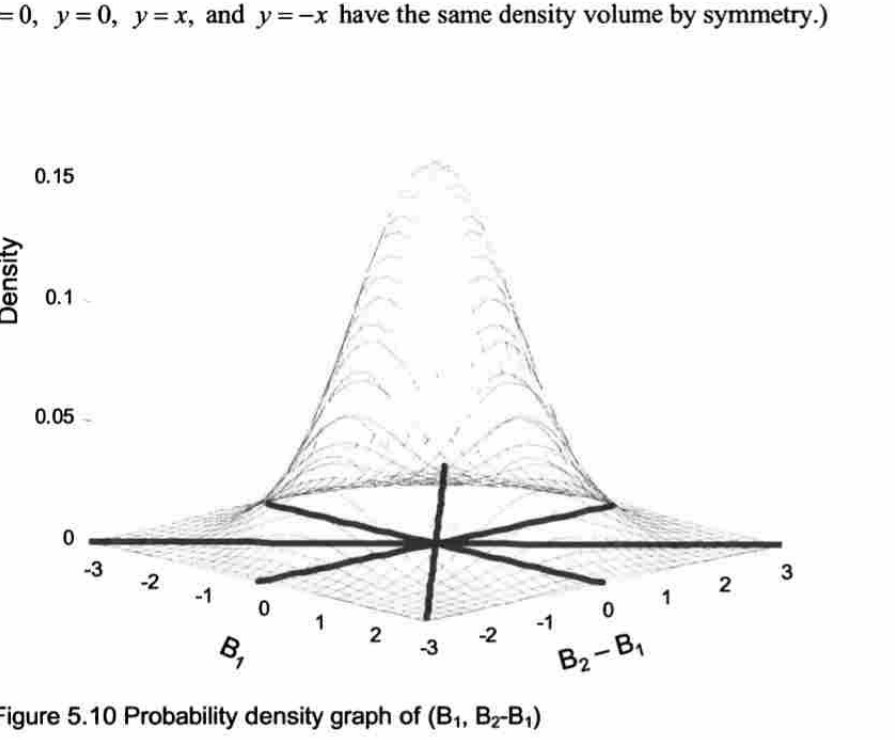
其实无需真正做积分。由于
B 1 B_1 B 2 − B 1 B_2-B_1
x = 0 , y = 0 , y = x , y = − x
x=0,\quad y=0,\quad y=x,\quad y=-x
分成8个对称区域,每个区域的联合密度概率质量相同。所求事件正好对应其中一个区域,因此概率是
1 / 8 1/8
也可以写成直观的条件概率分解:
P ( B 1 > 0 , B 2 < 0 ) = P ( B 1 > 0 ) P ( B 2 − B 1 < 0 ) P ( | B 2 − B 1 | > | B 1 | ) = 1 2 × 1 2 × 1 2 = 1 8 .
P(B_1>0,B_2<0)
=P(B_1>0)P(B_2-B_1<0)P(|B_2-B_1|>|B_1|)
=\frac12\times\frac12\times\frac12
=\frac18.
图5.10:( B 1 , B 2 − B 1 ) (B_1,B_2-B_1)
停时/首达时间(Stopping
time / first passage time)
题目:首次到达
− 1 -1 1 1
标准布朗运动从0出发,首次到达
− 1 -1 1 1
我的回答与笔记 查看解答⌄
已知
B t 2 − t
B_t^2-t
是鞅。用 Itô 引理可以验证:
d ( B t 2 − t ) = 2 B t d B t − d t + d t = 2 B t d B t ,
\begin{aligned}
d(B_t^2-t)
&=2B_t\,dB_t-dt+dt\\
&=2B_t\,dB_t,
\end{aligned}
因此没有漂移项。
令
T = inf { t : B t = 1 或 B t = − 1 } .
T=\inf\{t:B_t=1\text{ 或 }B_t=-1\}.
在满足适当条件时,停止后的鞅仍然是鞅,所以
E [ B T 2 − T ] = E [ B 0 2 ] = 0 .
E[B_T^2-T]=E[B_0^2]=0.
而布朗运动最终以概率1到达
1 1 − 1 -1
B T 2 = 1 .
B_T^2=1.
所以
E [ T ] = 1 .
\boxed{E[T]=1}.
题目:布朗运动的首达时间分布(Stopping
time B)
设
W ( t ) W(t) x > 0 x>0 x x
τ x = inf { t : W ( t ) = x } .
\tau_x=\inf\{t:W(t)=x\}.
求
τ x \tau_x E [ τ x ] E[\tau_x]
我的回答与笔记 查看解答⌄
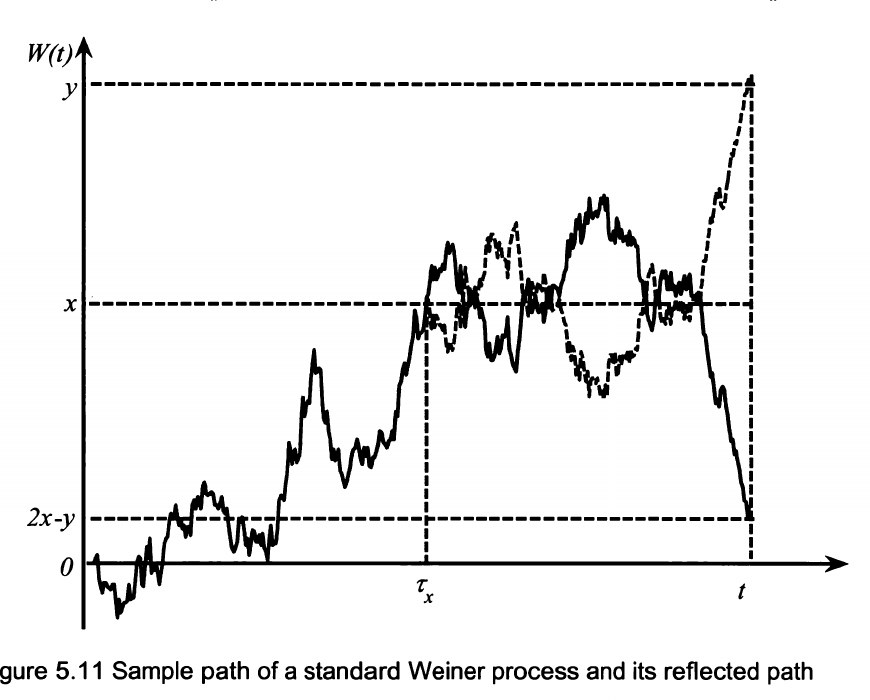
这是一道经典的反射原理问题。
对任何在时刻
t t x x t t x x x x x x t t x x
P ( τ x ≤ t ) = 2 P ( W ( t ) ≥ x ) .
P(\tau_x\le t)
=2P(W(t)\ge x).
由于
W ( t ) ∼ N ( 0 , t ) W(t)\sim N(0,t)
P ( τ x ≤ t ) = 2 ∫ x ∞ 1 2 π t e − w 2 / ( 2 t ) d w .
P(\tau_x\le t)
=2\int_x^\infty\frac{1}{\sqrt{2\pi t}}e^{-w^2/(2t)}\,dw.
令
v = w / t v=w/\sqrt t
P ( τ x ≤ t ) = 2 ∫ x / t ∞ 1 2 π e − v 2 / 2 d v = 2 − 2 Φ ( x t ) ,
P(\tau_x\le t)
=2\int_{x/\sqrt t}^{\infty}\frac1{\sqrt{2\pi}}e^{-v^2/2}\,dv
=2-2\Phi\left(\frac{x}{\sqrt t}\right),
其中
Φ \Phi
对
t t
f τ x ( t ) = x 2 π t − 3 / 2 exp ( − x 2 2 t ) , t > 0 .
\boxed{
f_{\tau_x}(t)
=\frac{x}{\sqrt{2\pi}}t^{-3/2}\exp\left(-\frac{x^2}{2t}\right),
\qquad t>0.
}
图5.11:标准 Wiener 过程的一条样本路径及其在首次到达水平
x x
虽然
P ( τ x < ∞ ) = 1 ,
P(\tau_x<\infty)=1,
但其期望却是无穷大:
E [ τ x ] = ∞ .
\boxed{E[\tau_x]=\infty}.
原书用前一问作直观说明:到达单边界
x x x x − ∞ -\infty α β \alpha\beta
题目:先到3还是先到−5(Stopping
time C)
设
X X
d X ( t ) = d W ( t ) ,
dX(t)=dW(t),
且
X ( 0 ) = 0 X(0)=0 m m
d X ( t ) = m d t + d W ( t ) ,
dX(t)=m\,dt+dW(t),
结果又是多少?
我的回答与笔记 查看解答⌄
先看无漂移情形。布朗运动本身是鞅。设
p 3 = P ( 先到 3 而不是 − 5 ) .
p_3=P(\text{先到 }3\text{ 而不是 }-5).
停止时
X T X_T
E [ X T ] = 0 ,
E[X_T]=0,
因此
3 p 3 − 5 ( 1 − p 3 ) = 0 .
3p_3-5(1-p_3)=0.
解得
p 3 = 5 8 .
\boxed{p_3=\frac58}.
更一般地,对于无漂移布朗运动,若上边界为
α > 0 \alpha>0 − β -\beta β > 0 \beta>0
P ( 先到 α ) = β α + β ,
P(\text{先到 }\alpha)=\frac{\beta}{\alpha+\beta},
且到任一边界的期望时间为
E [ T ] = α β .
E[T]=\alpha\beta.
现在考虑带漂移过程
d X = m d t + d W .
dX=m\,dt+dW.
此时
X X P ( x ) P(x) x ∈ ( − 5 , 3 ) x\in(-5,3) P P
m P ′ ( x ) + 1 2 P ″ ( x ) = 0 , − 5 < x < 3 ,
mP'(x)+\frac12P''(x)=0,
\qquad -5<x<3,
边界条件为
P ( 3 ) = 1 , P ( − 5 ) = 0 .
P(3)=1,
\qquad
P(-5)=0.
特征根为
r 1 = 0 , r 2 = − 2 m ,
r_1=0,
\qquad
r_2=-2m,
因此一般解为
P ( x ) = c 1 + c 2 e − 2 m x .
P(x)=c_1+c_2e^{-2mx}.
代入边界条件可得
P ( 0 ) = e 10 m − 1 e 10 m − e − 6 m .
\boxed{
P(0)=\frac{e^{10m}-1}{e^{10m}-e^{-6m}}.
}
原书还给出了更简洁的指数鞅方法。注意
W ( t ) = X ( t ) − m t
W(t)=X(t)-mt
是标准布朗运动,因此
Z ( t ) = exp { λ W ( t ) − 1 2 λ 2 t }
Z(t)=\exp\left\{\lambda W(t)-\frac12\lambda^2t\right\}
是鞅。取
λ = − 2 m \lambda=-2m
E [ e − 2 m X T ] = 1 .
E[e^{-2mX_T}]=1.
于是若
P 3 P_3
P 3 e − 6 m + ( 1 − P 3 ) e 10 m = 1 ,
P_3e^{-6m}+(1-P_3)e^{10m}=1,
解得与上式相同的结果。
题目:带正漂移的过程是否会到达−1(Stopping
time D)
设
d X = d t + d W ( t ) ,
dX=dt+dW(t),
其中
W ( t ) W(t) X ( 0 ) = 0 X(0)=0 X X − 1 -1
我的回答与笔记 查看解答⌄
利用上一问中的指数鞅结果,令漂移
m = 1 m=1
E [ e − 2 X T ] = 1 .
E[e^{-2X_T}]=1.
这里只有一个显式负边界
− 1 -1 + ∞ +\infty P − 1 P_{-1} − 1 -1
e − 2 ( − 1 ) = e 2 ,
e^{-2(-1)}=e^2,
而沿正方向趋于
+ ∞ +\infty
e − 2 X → 0 .
e^{-2X}\to0.
因此
P − 1 e 2 + ( 1 − P − 1 ) ⋅ 0 = 1 .
P_{-1}e^2+(1-P_{-1})\cdot0=1.
所以
P − 1 = e − 2 .
\boxed{P_{-1}=e^{-2}}.
Itô 引理(Itô’s lemma)
Itô 引理是普通微积分链式法则在随机微积分中的对应形式。
设
X ( t ) X(t)
d X ( t ) = β ( t , X ) d t + γ ( t , X ) d W ( t ) ,
dX(t)=\beta(t,X)\,dt+\gamma(t,X)\,dW(t),
并且
f ( X ( t ) , t ) f(X(t),t) X X t t
d f = ( ∂ f ∂ t + β ( t , X ) ∂ f ∂ x + 1 2 γ 2 ( t , X ) ∂ 2 f ∂ x 2 ) d t + γ ( t , X ) ∂ f ∂ x d W ( t ) .
\boxed{
df
=\left(
\frac{\partial f}{\partial t}
+\beta(t,X)\frac{\partial f}{\partial x}
+\frac12\gamma^2(t,X)\frac{\partial^2f}{\partial x^2}
\right)dt
+\gamma(t,X)\frac{\partial f}{\partial x}\,dW(t).
}
其中漂移项为
∂ f ∂ t + β ( t , X ) ∂ f ∂ x + 1 2 γ 2 ( t , X ) ∂ 2 f ∂ x 2 .
\frac{\partial f}{\partial t}
+\beta(t,X)\frac{\partial f}{\partial x}
+\frac12\gamma^2(t,X)\frac{\partial^2f}{\partial x^2}.
对于一个广义 Wiener 过程
d X = a ( x , t ) d t + b ( x , t ) d W ( t ) ,
dX=a(x,t)dt+b(x,t)dW(t),
若过程本身要成为鞅,其漂移系数必须为0;同样地,对
f ( X , t ) f(X,t)
题目:Z t = t B t Z_t=\sqrt t\,B_t
令
B t B_t
Z t = t B t .
Z_t=\sqrt t\,B_t.
求
Z t Z_t Z t Z_t
我的回答与笔记 查看解答⌄
在时刻
t t
B t ∼ N ( 0 , t ) .
B_t\sim N(0,t).
因此
Z t = t B t ∼ N ( 0 , t 2 ) .
Z_t=\sqrt t\,B_t
\sim N(0,t^2).
所以
E [ Z t ] = 0 , Var ( Z t ) = t 2 .
\boxed{E[Z_t]=0},
\qquad
\boxed{\operatorname{Var}(Z_t)=t^2}.
虽然对每个固定
t t
对
Z ( t , B ) = t B
Z(t,B)=\sqrt t\,B
应用 Itô 引理:
∂ Z ∂ B = t , ∂ Z ∂ t = 1 2 t − 1 / 2 B , ∂ 2 Z ∂ B 2 = 0 .
\frac{\partial Z}{\partial B}=\sqrt t,
\qquad
\frac{\partial Z}{\partial t}=\frac12t^{-1/2}B,
\qquad
\frac{\partial^2Z}{\partial B^2}=0.
因此
d Z t = 1 2 t − 1 / 2 B t d t + t d B t .
dZ_t
=\frac12t^{-1/2}B_t\,dt+\sqrt t\,dB_t.
除
B t = 0 B_t=0 B t ≠ 0 B_t\neq0
Z t = t B t 不是鞅 .
\boxed{Z_t=\sqrt t\,B_t\text{ 不是鞅}}.
题目:W ( t ) 3 W(t)^3
令
W ( t ) W(t)
W ( t ) 3
W(t)^3
是否为鞅?
我的回答与笔记 查看解答⌄
取
f ( W , t ) = W 3 .
f(W,t)=W^3.
则
∂ f ∂ W = 3 W 2 , ∂ 2 f ∂ W 2 = 6 W , ∂ f ∂ t = 0 .
\frac{\partial f}{\partial W}=3W^2,
\qquad
\frac{\partial^2f}{\partial W^2}=6W,
\qquad
\frac{\partial f}{\partial t}=0.
由 Itô 引理,
d ( W 3 ) = 3 W 2 d W + 1 2 ⋅ 6 W d t = 3 W 2 d W + 3 W d t .
d(W^3)
=3W^2\,dW+\frac12\cdot6W\,dt
=3W^2\,dW+3W\,dt.
漂移项为
3 W d t ,
3W\,dt,
通常不为0,因此
W ( t ) 3 不是鞅 .
\boxed{W(t)^3\text{ 不是鞅}}.